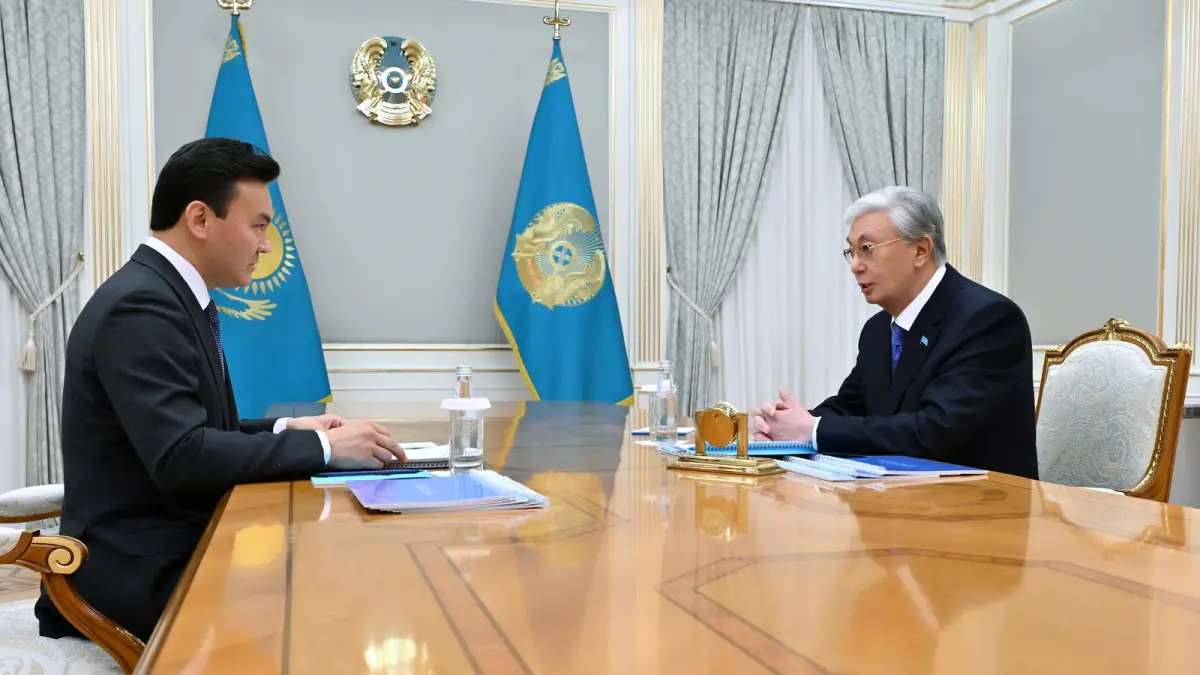
Астана, 9 қараша. Қазақстан Президенті Қасым-Жомарт Тоқаев халықаралық «Қазақ тілі» қоғамының төрағасы Рауан Кенжеханұлын қабылдады, ол OpenAI компаниясымен бірлескен жоба туралы айтты: қазақ тілінің мәтін корпусы 14 млрд токенге жетті, ал аудиожазбалар базасы 12 мың сағатқа жетті, деп хабарлады Ақорда.
Президентке қоғам үш бағытта жұмыс істейтіні баяндалды: қазақ тілін оқыту әдістемесін жетілдіреді, қазақша мазмұнды байытады және тілдің жаңа технологиялардағы қолданысын кеңейтеді. Соңғы үш жылда Disney, Pixar және Sony студияларының 13 танымал фильмі қазақ тілінде дыбысталып, үлкен экранға шықты. Qazaq Tili Endowment қорының жұмысы туралы жарна көлемі 824 млн теңгеге жеткені айтылды. Тоқаев қоғамның қызметіне жоғары баға беріп, мемлекеттік тілді үйрету мен оқытуда, сондай-ақ ғылыми шығармаларды аударуда жасанды интеллектінің әлеуетін барынша пайдалану маңызды екенін атап өтті.
Токен — мәтіннің бір бірлігі: жасанды интеллект моделі тілді өңдегенде сөздер мен сөйлемдерді осындай бірліктерге бөледі, деп түсіндірді «24KZ». Корпус — модельді оқыту үшін жиналған мәтіндер: Kazakh Text Corpus корпусына білім, ғылым, технология, экономика, құқық, медицина, тарих, этнография және медиа бойынша материалдар, сондай-ақ балалар мазмұны кірді, деп айтты BAQ.KZ. Материалдар тақырыбы, жанры және жас санаты бойынша жіктеліп, тазартылады.
Аудиобаза — 12 мың сағатқа созылатын, бөгде дыбыстардан тазартылған қазақ сөйлеуінің жазбалары. BAQ.KZ деректері бойынша, қазақ тіліне бейімделген сөйлеуді тану модельдерінің дәлдігі 98%-ға жеткізілген.
Мұның не үшін қажет екенін Кенжеханұлының өзі түсіндірді. «Біз үшін мұндай құрал қазақ тілінде қатесіз, қазір айтатындай, галлюцинациясыз жұмыс істеуі маңызды», — деді ол (галлюцинация деп модельдің ойдан шығарған жауаптарын атайды). Оның сөзінше, жиналған деректер негізінде OpenAI командасымен бірге ChatGPT секілді жүйені қайта оқытады. Қиындық, ол Kazinform агенттігіне айтқандай, қазақша деректердің ағылшын немесе орыс тіліндегіге қарағанда әлдеқайда аз болуында, сондықтан материалдарды қажетті рұқсаттар алынғаннан кейін мұрағаттардан, мұражайлардан және кітапханалардан жинайды. Жұмыс 2025 жылғы 7 қарашада Мемлекет басшысының АҚШ-қа сапары кезінде Вашингтонда жасалған келісім аясында жүріп жатыр.
Жобаның құны қанша, оны кім төлейтіні, ChatGPT жүйесінің қазақшасы қашан және қай нұсқада жақсаратыны және сапаны қалай өлшейтіні Ақорданың хабарламасында айтылмаған. ChatGPT жүйесін осы деректермен қайта оқыту туралы сөздер қоғам басшысына тиесілі; OpenAI компаниясынан расталған мәлімет зерттелген материалдарда жоқ.
Мәні неде: Мемлекет жасанды интеллектті қазақ тілін сақтау мен оқытудың құралы деп атайды, ал OpenAI компаниясымен жоба мұның іс жүзінде қалай көрінетінін көрсетеді: деректер жиналып, оқыту үшін тәртіпке келтіріледі. Жобаның сандары — 14 млрд токен, 12 мың сағат сөйлеу, 98% дәлдік — орындаушының өз есебі, сапаның тәуелсіз бағасы әзірге жоқ.
Бұл кімге тиімді: Президенттің сөзінше, мемлекеттік тілді үйренетіндер мен оқытатындарға және ғылыми әдебиетті аудармашыларға. Кенжеханұлы жақсартылған модель басқа тілдерде сөйлейтін, Қазақстанның тарихы мен мәдениеті қызықтыратын пайдаланушыларға да пайдалы болатынын қосты. OpenAI қандай пайда алатыны келісімнің шарттарында ашылмаған.
Негізгі мәлімет: Халықаралық «Қазақ тілі» қоғамы — қазақ тілін дамытумен айналысатын қоғамдық ұйым. Qazaq Tili Endowment — мақсатты капитал қоры: эндаумент деп табысы жарғылық мақсаттарға жұмсалатын капиталды атайды.
Бұған дейін біз Хуанг Қазақстанды физикалық ЖИ хабы ету туралы ұсыныс жасағаны туралы да жазған едік.